Tag: Chinook

  • วิธีใช้ SQLAlchemy วิเคราะห์ข้อมูลจาก Database โดยไม่ต้องออกจาก Python

    วิธีใช้ SQLAlchemy วิเคราะห์ข้อมูลจาก Database โดยไม่ต้องออกจาก Python

    Updated: 31 Jul 2026

    .

    SQLAlchemy เป็น Python package ยอดนิยมสำหรับเชื่อมต่อกับ database ทั้งสำหรับพัฒนาเว็บแอปพลิเคชัน (web application) และการวิเคราะห์ข้อมูล (data analytics)

    นอกจาก SQLAlchemy จะช่วยให้เราเชื่อมต่อกับ database หลากหลายประเภท ไม่ว่าจะเป็น:

    • SQLite
    • PostgreSQL
    • MySQL
    • และอีกมากมาย

    SQLAlchemy ยังช่วยให้เราทำงานกับ database ได้โดยไม่ต้องรู้ SQL (Structured Query Language) ก็ได้ โดยทำหน้าที่เป็น Object-Relational Mapper (ORM) ที่แปลงข้อมูลใน database ให้เป็น Python object ที่เราใช้งานต่อได้

    ในบทความนี้ ผมจะพาทุกคนไปดูวิธีใช้ SQLAlchemy คู่กับ Pandas เพื่อวิเคราะห์ข้อมูลใน database โดยไม่ต้องออกจาก Python กัน

    ถ้าพร้อมแล้ว ไปเริ่มกันเลย


    1. 🚀 Overview
    2. 1️⃣ Step 1. เชื่อมต่อกับ Database
    3. 2️⃣ Step 2. ดูโครงสร้าง Database
    4. 3️⃣ Step 3. เขียน SQL
    5. 4️⃣ Step 4. โหลดข้อมูล
    6. 5️⃣ Step 5. วิเคราะห์ข้อมูล
    7. 💪 Summary
    8. ⏭️ Next
    9. 📃 References

    🚀 Overview

    การทำงานกับ SQLAlchemy มีอยู่ 5 ขั้นตอน:

    1. เชื่อมต่อกับ database
    2. ดูโครงสร้าง database
    3. เขียน SQL
    4. โหลดข้อมูล
    5. วิเคราะห์ข้อมูล

    เราไปดูตัวอย่าง ผ่านการทำงานกับ Chinook SQLite ที่มีข้อมูลของร้านขาย digital media (เช่น ข้อมูลลูกค้า เพลง นักร้อง) กัน


    1️⃣ Step 1. เชื่อมต่อกับ Database

    ในขั้นแรก เราจะเชื่อมกับ database โดยสร้าง Engine object ที่เก็บข้อมูลการเชื่อมต่อ database ไว้ให้:

    Python
    # Import the package
    from sqlalchemy import create_engine
    # Connect to the database
    engine = create_engine("sqlite:///chinook.sqlite")

    2️⃣ Step 2. ดูโครงสร้าง Database

    ในขั้นที่ 2 เราจะสำรวจโครงสร้าง database ว่ามี table อะไรอยู่บ้าง:

    Python
    # Import the package
    from sqlalchemy import inspect
    # Get the inspector
    inspector = inspect(engine)
    # List the table names
    table_names = inspector.get_table_names()
    # Print the table names
    print(table_names)

    ผลลัพธ์:

    [
    "Album",
    "Artist",
    "Customer",
    "Employee",
    "Genre",
    "Invoice",
    "InvoiceLine",
    "MediaType",
    "Playlist",
    "PlaylistTrack",
    "Track",
    ]

    3️⃣ Step 3. เขียน SQL

    ในขั้นที่ 3 เราจะเขียน SQL สำหรับดึงข้อมูลจาก database:

    Python
    # Import the package
    from sqlalchemy import text
    # Set a query
    query = text(
    """
    SELECT
    InvoiceId,
    InvoiceDate,
    BillingCountry,
    Total
    FROM Invoice;
    """
    )

    Note:

    ถ้าใช้ SQL ไม่เป็น เราสามารถใช้ SQLAlchemy เพื่อสร้าง SQL ขึ้นมาให้เราได้ เช่น:

    Python
    # Import the package
    from sqlalchemy import select
    # Create a query
    query = (
    select(
    invoice.c.InvoiceId,
    invoice.c.InvoiceDate,
    invoice.c.BillingCountry,
    invoice.c.Total,
    )
    )

    4️⃣ Step 4. โหลดข้อมูล

    ในขั้นที่ 4 เราจะโหลดข้อมูลเข้ามาใน Python ด้วย Pandas:

    Python
    # Import the package
    import pandas as pd
    # Load the table
    df = pd.read_sql(
    query,
    engine
    )
    # Inspect the df
    df.head()

    ผลลัพธ์:


    5️⃣ Step 5. วิเคราะห์ข้อมูล

    ในขั้นสุดท้าย เราจะวิเคราะห์ข้อมูลด้วย Pandas เช่น หาค่าเฉลี่ยต่อประเทศ:

    # Find mean total by country
    (
    df
    .groupby("BillingCountry", as_index=False)
    .agg(MeanTotal=("Total", "mean"))
    .sort_values("MeanTotal", ascending=False)
    )

    ผลลัพธ์:


    💪 Summary

    SQLAlchemy เป็น package ที่ช่วยให้เราทำงานกับ database ได้โดยไม่ต้องออกจาก Python และใช้งานง่ายใน 5 ขั้นตอน:

    1. เชื่อมต่อกับ database
    2. ดูโครงสร้าง database
    3. เขียน SQL
    4. โหลดข้อมูล
    5. วิเคราะห์ข้อมูล

    ⏭️ Next

    หลังอ่านบทความจบแล้ว ลองใช้ SQLAlchemy เพื่อทำงานกับ database กันดูนะครับ:


    📃 References

  • dbplyr: แนะนำ package และ 6 ขั้นตอนในการทำงานกับ database ด้วย dplyr syntax ในภาษา R — ตัวอย่างการทำงานกับ Chinook database

    dbplyr: แนะนำ package และ 6 ขั้นตอนในการทำงานกับ database ด้วย dplyr syntax ในภาษา R — ตัวอย่างการทำงานกับ Chinook database

    ในบทความนี้ เราจะไปดูวิธีใช้ dbplyr ซึ่งเป็น package สำหรับทำงานกับ database ในภาษา R และเหมาะกับคนที่ต้องการทำงานโดยใช้ภาษา R เป็นหลักกัน

    ถ้าพร้อมแล้ว ไปเริ่มกันเลย


    1. 🤔 What Is dbplyr?
    2. 🏁 Getting Started
    3. 🏃‍♂️‍➡️ Using dbplyr
      1. 1️⃣ Connect to the Database
      2. 2️⃣ Create a Lazy Tibble
      3. 3️⃣ Create a Query
      4. 4️⃣ Show the Query
      5. 5️⃣ Collect the Result
      6. 6️⃣ Disconnect the Database
    4. 💪 Summary
    5. 😺 GitHub
    6. 📃 References
    7. ✅ R Book for Psychologists: หนังสือภาษา R สำหรับนักจิตวิทยา

    🤔 What Is dbplyr?

    dbplyr เป็น package ในภาษา R สำหรับทำงานกับ database โดยใช้ dplyr syntax แทน SQL เช่น แทนที่เราเขียน:

    SELECT * FROM table

    เราสามารถใช้ dplyr syntax ได้แบบนี้:

    select(table, everything())

    (Note: อ่านวิธีใช้ dplyr ได้ที่นี่)


    🏁 Getting Started

    เราสามารถเริ่มใช้งาน dbplyr ได้โดยติดตั้งและโหลด 4 packages ดังนี้:

    1. DBI: สำหรับเชื่อมต่อกับ database (อ่านวิธีใช้เพิ่มเติมได้ที่นี่)
    2. RSQLite: สำหรับเชื่อมต่อกับ SQLite database (เราจะเปลี่ยน package นี้ตาม database ที่เราใช้ เช่น RPostgres สำหรับ Postgres database)
    3. dplyr: สำหรับ dplyr syntax เช่น select(), filter(), arrange()
    4. dbplyr: สำหรับทำงานกับ database ด้วย dplyr syntax
    # Install packages
    install.packages("DBI")
    install.packages("RSQLite")
    install.packages("dplyr")
    install.packages("dbplyr")
    
    # Load packages
    library(DBI)
    library(RSQLite)
    library(dplyr)
    library(dbplyr)

    🏃‍♂️‍➡️ Using dbplyr

    เราสามารถใช้ dbplyr เพื่อทำงานกับ database ได้ใน 6 ขั้นตอน:

    1. Connect to the database
    2. Create a lazy tibble
    3. Create a query
    4. Show the query
    5. Get the result

    .

    1️⃣ Connect to the Database

    ในขั้นแรก เราจะเชื่อมต่อกับ local database ด้วย DBI::dbConnect และ RSQLite::SQLite():

    # Connect to database
    con <- dbConnect(RSQLite::SQLite(),
                     "chinook.sqlite")

    Note: โหลด “chinook.sqlite” ได้จาก GitHub

    .

    2️⃣ Create a Lazy Tibble

    ในขั้นที่ 2 เราจะสร้าง lazy tibble หรือ object ที่ใช้แทน database table ซึ่งทำได้ใน 2 steps:

    Step 1. ดูรายชื่อ table ทั้งหมด ใน database ด้วย DBI::dbListTables():

    # View all tables
    dbListTables(con)

    ผลลัพธ์:

     [1] "Album"         "Artist"        "Customer"      "Employee"     
     [5] "Genre"         "Invoice"       "InvoiceLine"   "MediaType"    
     [9] "Playlist"      "PlaylistTrack" "Track" 

    Step 2. สร้าง lazy tibble จากชื่อ table ที่ต้องการ ด้วย dplyr::tbl():

    # Create lazy tibble
    tracks <- tbl(con,
                  "Track")
    
    # View tibble
    tracks

    ผลลัพธ์:

    # Source:   table<`Track`> [?? x 9]
    # Database: sqlite 3.50.1 [C:\\My Code\\RStudio\\chinook.sqlite]
       TrackId Name           AlbumId MediaTypeId GenreId Composer Milliseconds  Bytes UnitPrice
         <int> <chr>            <int>       <int>   <int> <chr>           <int>  <int>     <dbl>
     1       1 For Those Abo…       1           1       1 Angus Y…       343719 1.12e7      0.99
     2       2 Balls to the …       2           2       1 NA             342562 5.51e6      0.99
     3       3 Fast As a Sha…       3           2       1 F. Balt…       230619 3.99e6      0.99
     4       4 Restless and …       3           2       1 F. Balt…       252051 4.33e6      0.99
     5       5 Princess of t…       3           2       1 Deaffy …       375418 6.29e6      0.99
     6       6 Put The Finge…       1           1       1 Angus Y…       205662 6.71e6      0.99
     7       7 Let's Get It …       1           1       1 Angus Y…       233926 7.64e6      0.99
     8       8 Inject The Ve…       1           1       1 Angus Y…       210834 6.85e6      0.99
     9       9 Snowballed           1           1       1 Angus Y…       203102 6.60e6      0.99
    10      10 Evil Walks           1           1       1 Angus Y…       263497 8.61e6      0.99
    # ℹ more rows
    # ℹ Use `print(n = ...)` to see more rows

    .

    3️⃣ Create a Query

    ในขั้นที่ 3 เราจะเขียน dplyr syntax เพื่อ query table ที่ต้องการ

    เช่น สรุปข้อมูลจำนวนเพลง ค่าเฉลี่ยความยาวเพลง (Milliseconds) และขนาดเพลง (Bytes) ของแต่ละ album:

    # Create query
    album_info <- tracks |>
      
      # Group by album
      group_by(AlbumId) |>
      
      # Summarise
      summarise(
        
        # Number of tracks
        tracks = n(),
        
        # Average duration
        mean_millisec = mean(Milliseconds,
                             na.rm = TRUE),
        
        # Total size
        total_bytes = sum(Bytes)
      ) |>
      
      # Sort by duration
      arrange(desc(mean_millisec))

    ตอนนี้ code ของเราจะยังไม่ถูกส่งไปยัง database เพราะ lazy tibble จะเก็บคำสั่งไว้จนกว่าเราจะมีคำสั่งให้ส่ง

    เราไปดูคำสั่งที่เราสามารถใช้กับ code ที่ยังไม่ถูกส่งไปกัน

    .

    4️⃣ Show the Query

    เราสามารถใช้ dbplyr::show_query() เพื่อดู SQL ที่จะถูกส่งไปยัง database (ซึ่งแปลงมาจาก dplyr syntax ของเรา) ได้:

    # Show query
    show_query(album_info)

    ผลลัพธ์:

    <SQL>
    SELECT
      `AlbumId`,
      COUNT(*) AS `tracks`,
      AVG(`Milliseconds`) AS `mean_millisec`,
      SUM(`Bytes`) AS `total_bytes`
    FROM `Track`
    GROUP BY `AlbumId`
    ORDER BY `mean_millisec` DESC

    .

    5️⃣ Collect the Result

    เราสามารถส่ง code เพื่อไป query database ได้ด้วย dbplyr::collect():

    # Get result
    album_info_tb <- collect(album_info)
    
    # View the result
    album_info_tb

    ผลลัพธ์:

    # A tibble: 347 × 4
       AlbumId tracks mean_millisec total_bytes
         <int>  <int>         <dbl>     <int64>
     1     253     24      2925574. 12872621850
     2     227     19      2778265. 10059916535
     3     229     26      2717907  13917603291
     4     231     24      2637068. 12344960921
     5     226      1      2622250    490750393
     6     228     23      2599142. 11781321607
     7     230     25      2594197.  5280909854
     8     254      1      2484567    492670102
     9     261     17      2321673.  7708725642
    10     251     25      1532684.  7652731262
    # ℹ 337 more rows
    # ℹ Use `print(n = ...)` to see more rows

    .

    6️⃣ Disconnect the Database

    สุดท้าย เมื่อเราทำงานเสร็จแล้ว เราจะปิดการเชื่อมต่อกับ database ด้วย DBI::dbDisconnect():

    # Disconnect from database
    dbDisconnect(con)

    เป็นการจบ loop การทำงานกับ database ด้วย dbplyr


    💪 Summary

    ในบทความนี้ เราได้ไปทำความรู้จัก 6 ขั้นตอนในการใช้ dbplyr เพื่อทำงานกับ database ในภาษา R กัน:

    1. Connect to the database: DBI::dbConnect() และ RSQLite::SQLite()
    2. Create a lazy tibble: dplyr::tbl()
    3. Create a query: ใช้ dplyr syntax คู่กับ lazy tibble
    4. Show the query: dbplyr::show_query()
    5. Collect the result: dbplyr::collect()
    6. Disconnect the database: DBI::dbDisconnect()

    😺 GitHub

    ดูตัวอย่าง code และ database ในบทความนี้ได้ที่ GitHub


    📃 References


    ✅ R Book for Psychologists: หนังสือภาษา R สำหรับนักจิตวิทยา

    📕 ขอฝากหนังสือเล่มแรกในชีวิตด้วยนะครับ 😆

    🙋 ใครที่กำลังเรียนจิตวิทยาหรือทำงานสายจิตวิทยา และเบื่อที่ต้องใช้ software ราคาแพงอย่าง SPSS และ Excel เพื่อทำข้อมูล

    💪 ผมขอแนะนำ R Book for Psychologists หนังสือสอนใช้ภาษา R เพื่อการวิเคราะห์ข้อมูลทางจิตวิทยา ที่เขียนมาเพื่อนักจิตวิทยาที่ไม่เคยมีประสบการณ์เขียน code มาก่อน

    ในหนังสือ เราจะปูพื้นฐานภาษา R และพาไปดูวิธีวิเคราะห์สถิติที่ใช้บ่อยกัน เช่น:

    • Correlation
    • t-tests
    • ANOVA
    • Reliability
    • Factor analysis

    🚀 เมื่ออ่านและทำตามตัวอย่างใน R Book for Psychologists ทุกคนจะไม่ต้องพึง SPSS และ Excel ในการทำงานอีกต่อไป และสามารถวิเคราะห์ข้อมูลด้วยตัวเองได้ด้วยความมั่นใจ

    แล้วทุกคนจะแปลกใจว่า ทำไมภาษา R ง่ายขนาดนี้ 🙂‍↕️

    👉 สนใจดูรายละเอียดหนังสือได้ที่ meb:
  • DBI: แนะนำ 4 ขั้นตอนในการเชื่อมต่อและ query ข้อมูลจาก database โดยใช้ภาษา R — ตัวอย่างการทำงานกับ Chinook database

    DBI: แนะนำ 4 ขั้นตอนในการเชื่อมต่อและ query ข้อมูลจาก database โดยใช้ภาษา R — ตัวอย่างการทำงานกับ Chinook database

    ในบทความนี้ เราจะมาดู 4 ขั้นตอนในการเชื่อมต่อและทำงานกับ database ในภาษา R ด้วย DBI package กัน:

    1. Get started
    2. Explore the database
    3. Query the database
    4. Close the connection

    ถ้าพร้อมแล้ว ไปเริ่มกันเลย


    1. 💻 Step 1. Get Started
      1. 📦 DBI Package
      2. ⬇️ Install & Connect
    2. 👀 Step 2. Explore the Database
      1. 1️⃣ dbListTable()
      2. 2️⃣ dbGetQuery()
    3. 🔍 Step 3. Query the Database
      1. 1️⃣ dbReadTable()
      2. 2️⃣ dbGetQuery()
      3. 3️⃣ dbSendQuery()
    4. 🤚 Step 4. Close the Connection
    5. 💪 Summary
    6. 😺 GitHub
    7. 📃 References
    8. ✅ R Book for Psychologists: หนังสือภาษา R สำหรับนักจิตวิทยา

    💻 Step 1. Get Started

    📦 DBI Package

    DBI (Database Interface) เป็น package สำหรับเชื่อมต่อกับ database ซึ่งทำให้เราทำงานกับ database ในภาษา R ได้โดยตรง

    ในบทความนี้ เรามาลองดูการใช้งาน DBI ผ่านการทำงานกับ Chinook SQLite database กัน (เราสามารถโหลด Chinook เพื่อลองทำตามได้จาก GitHub)

    .

    ⬇️ Install & Connect

    ในขั้นแรกของการใช้งาน เราจะติดตั้งและโหลด DBI พร้อมกับ package สำหรับ database ที่เราจะทำงานด้วย

    อย่างในกรณีนี้ เราจะติดตั้งและโหลด RSQLite package เพราะเราจะทำงานกับ SQLite database

    Note: ถ้าเราทำงานกับ database อื่น เราจะต้องติดตั้งและโหลด package อื่น เช่น:

    • MySQL → RMySQL
    • PostgresSQL → RPostgresSQL
    • Oracle → ROracle

    ติดตั้ง packages:

    # Install
    install.packages("DBI")
    install.packages("RSQLite")

    โหลด packages:

    # Load
    library(DBI)
    library(RSQLite)

    หลังติดตั้งและโหลด packages แล้ว เราจะเชื่อมต่อกับ database ด้วย dbConnect() แบบนี้:

    # Connect to database
    con <- dbConnect(RSQLite::SQLite(),
                     "chinook.sqlite")

    Note: ในกรณีที่ database ไม่ได้อยู่ใน working directory เราจะต้องใช้ absolute file path แทนชื่อไฟล์ เช่น:

    # Connect to database
    con <- dbConnect(RSQLite::SQLite(),
                     "C:/Users/YourUser/Documents/R_Projects/my_data/chinook.sqlite")

    เท่านี้ เราก็พร้อมที่จะทำงานกับ database กันแล้ว


    👀 Step 2. Explore the Database

    เริ่มแรก เราจะสำรวจ database เพื่อทำความเข้าใจโครงสร้างข้อมูลกันก่อน

    เรามี 2 functions ที่ช่วยเราได้ ได้แก่:

    1. dbListTables(): ดูรายชื่อ tables ทั้งหมดใน database
    2. dbGetQuety(): ดู columns ใน table ที่ต้องการ

    .

    1️⃣ dbListTable()

    ตัวอย่าง:

    # List tables in the database
    dbListTables(con)

    ผลลัพธ์:

     [1] "Album"         "Artist"        "Customer"      "Employee"     
     [5] "Genre"         "Invoice"       "InvoiceLine"   "MediaType"    
     [9] "Playlist"      "PlaylistTrack" "Track"  

    .

    2️⃣ dbGetQuery()

    ตัวอย่าง:

    # List columns in a table
    dbGetQuery(con,
               "PRAGMA table_info(Artist)")

    ผลลัพธ์:

      cid     name          type notnull dflt_value pk
    1   0 ArtistId       INTEGER       1         NA  1
    2   1     Name NVARCHAR(120)       0         NA  0

    ในกรณีที่เราต้องการดู columns ในทุก table เราสามารถใช้ for loop ช่วยได้แบบนี้:

    # Get the table list
    tables <- dbListTables(con)
    
    # Get all columns
    for (table_name in tables) {
      
      # Print the table name
      message(paste0("\\n👉 Table: ", table_name))
      
      # Get the columns
      column_info <- dbGetQuery(con,
                                paste0("PRAGMA table_info(",
                                       table_name, 
                                       ")"))
      
      # Print the columns
      print(column_info)
    }

    ผลลัพธ์:

    👉 Table: Album
      cid     name          type notnull dflt_value pk
    1   0  AlbumId       INTEGER       1         NA  1
    2   1    Title NVARCHAR(160)       1         NA  0
    3   2 ArtistId       INTEGER       1         NA  0
    👉 Table: Artist
      cid     name          type notnull dflt_value pk
    1   0 ArtistId       INTEGER       1         NA  1
    2   1     Name NVARCHAR(120)       0         NA  0
    👉 Table: Customer
       cid         name         type notnull dflt_value pk
    1    0   CustomerId      INTEGER       1         NA  1
    2    1    FirstName NVARCHAR(40)       1         NA  0
    3    2     LastName NVARCHAR(20)       1         NA  0
    4    3      Company NVARCHAR(80)       0         NA  0
    5    4      Address NVARCHAR(70)       0         NA  0
    6    5         City NVARCHAR(40)       0         NA  0
    7    6        State NVARCHAR(40)       0         NA  0
    8    7      Country NVARCHAR(40)       0         NA  0
    9    8   PostalCode NVARCHAR(10)       0         NA  0
    10   9        Phone NVARCHAR(24)       0         NA  0
    11  10          Fax NVARCHAR(24)       0         NA  0
    12  11        Email NVARCHAR(60)       1         NA  0
    13  12 SupportRepId      INTEGER       0         NA  0
    👉 Table: Employee
       cid       name         type notnull dflt_value pk
    1    0 EmployeeId      INTEGER       1         NA  1
    2    1   LastName NVARCHAR(20)       1         NA  0
    3    2  FirstName NVARCHAR(20)       1         NA  0
    4    3      Title NVARCHAR(30)       0         NA  0
    5    4  ReportsTo      INTEGER       0         NA  0
    6    5  BirthDate     DATETIME       0         NA  0
    7    6   HireDate     DATETIME       0         NA  0
    8    7    Address NVARCHAR(70)       0         NA  0
    9    8       City NVARCHAR(40)       0         NA  0
    10   9      State NVARCHAR(40)       0         NA  0
    11  10    Country NVARCHAR(40)       0         NA  0
    12  11 PostalCode NVARCHAR(10)       0         NA  0
    13  12      Phone NVARCHAR(24)       0         NA  0
    14  13        Fax NVARCHAR(24)       0         NA  0
    15  14      Email NVARCHAR(60)       0         NA  0
    👉 Table: Genre
      cid    name          type notnull dflt_value pk
    1   0 GenreId       INTEGER       1         NA  1
    2   1    Name NVARCHAR(120)       0         NA  0
    👉 Table: Invoice
      cid              name          type notnull dflt_value pk
    1   0         InvoiceId       INTEGER       1         NA  1
    2   1        CustomerId       INTEGER       1         NA  0
    3   2       InvoiceDate      DATETIME       1         NA  0
    4   3    BillingAddress  NVARCHAR(70)       0         NA  0
    5   4       BillingCity  NVARCHAR(40)       0         NA  0
    6   5      BillingState  NVARCHAR(40)       0         NA  0
    7   6    BillingCountry  NVARCHAR(40)       0         NA  0
    8   7 BillingPostalCode  NVARCHAR(10)       0         NA  0
    9   8             Total NUMERIC(10,2)       1         NA  0
    👉 Table: InvoiceLine
      cid          name          type notnull dflt_value pk
    1   0 InvoiceLineId       INTEGER       1         NA  1
    2   1     InvoiceId       INTEGER       1         NA  0
    3   2       TrackId       INTEGER       1         NA  0
    4   3     UnitPrice NUMERIC(10,2)       1         NA  0
    5   4      Quantity       INTEGER       1         NA  0
    👉 Table: MediaType
      cid        name          type notnull dflt_value pk
    1   0 MediaTypeId       INTEGER       1         NA  1
    2   1        Name NVARCHAR(120)       0         NA  0
    👉 Table: Playlist
      cid       name          type notnull dflt_value pk
    1   0 PlaylistId       INTEGER       1         NA  1
    2   1       Name NVARCHAR(120)       0         NA  0
    👉 Table: PlaylistTrack
      cid       name    type notnull dflt_value pk
    1   0 PlaylistId INTEGER       1         NA  1
    2   1    TrackId INTEGER       1         NA  2
    👉 Table: Track
      cid         name          type notnull dflt_value pk
    1   0      TrackId       INTEGER       1         NA  1
    2   1         Name NVARCHAR(200)       1         NA  0
    3   2      AlbumId       INTEGER       0         NA  0
    4   3  MediaTypeId       INTEGER       1         NA  0
    5   4      GenreId       INTEGER       0         NA  0
    6   5     Composer NVARCHAR(220)       0         NA  0
    7   6 Milliseconds       INTEGER       1         NA  0
    8   7        Bytes       INTEGER       0         NA  0
    9   8    UnitPrice NUMERIC(10,2)       1         NA  0

    🔍 Step 3. Query the Database

    หลังสำรวจ database แล้ว เราสามารถ query ข้อมูลได้ด้วย 3 functions ได้แก่:

    1. dbReadTable()
    2. dbGetQuery()
    3. dbSendQuery()

    .

    1️⃣ dbReadTable()

    เราจะใช้ dbReadTable() เมื่อต้องการดึงข้อมูลทั้งหมดมาจาก table ที่ต้องการ

    ตัวอย่างเช่น ดูข้อมูลทั้งหมดใน Genre:

    # Query with dbReadTable()
    dbReadTable(con,
                "Genre")

    ผลลัพธ์:

       GenreId               Name
    1        1               Rock
    2        2               Jazz
    3        3              Metal
    4        4 Alternative & Punk
    5        5      Rock And Roll
    6        6              Blues
    7        7              Latin
    8        8             Reggae
    9        9                Pop
    10      10         Soundtrack
    11      11         Bossa Nova
    12      12     Easy Listening
    13      13        Heavy Metal
    14      14           R&B/Soul
    15      15  Electronica/Dance
    16      16              World
    17      17        Hip Hop/Rap
    18      18    Science Fiction
    19      19           TV Shows
    20      20   Sci Fi & Fantasy
    21      21              Drama
    22      22             Comedy
    23      23        Alternative
    24      24          Classical
    25      25              Opera

    .

    2️⃣ dbGetQuery()

    ในกรณีที่เราต้องการดูข้อมูลแบบเจาะจง เราจะใช้ dbGetQuery() ซึ่งต้องการ 2 arguments:

    1. Connection ที่เชื่อมต่อกับ database
    2. SQL query ที่กำหนดข้อมูลที่ต้องการจาก database

    ตัวอย่างการใช้งาน #1 – ดึงข้อมูลลูกค้าที่มาจากบราซิล:

    # Query with dbGetQuery() - example 1
    dbGetQuery(con,
               "SELECT
                  CustomerId,
                  FirstName,
                  LastName, Email
                FROM
                  Customer
                WHERE
                  country = 'Brazil';")

    ผลลัพธ์:

      CustomerId FirstName  LastName                         Email
    1          1      Luís Gonçalves          luisg@embraer.com.br
    2         10   Eduardo   Martins      eduardo@woodstock.com.br
    3         11 Alexandre     Rocha              alero@uol.com.br
    4         12   Roberto   Almeida roberto.almeida@riotur.gov.br
    5         13  Fernanda     Ramos      fernadaramos4@uol.com.br

    ตัวอย่าง #2 – คำนวณยอดขายรวมของแต่ละประเทศ โดยเรียงจากมากไปน้อย:

    # Query with dbGetQuery() - example 2
    dbGetQuery(con,
               "SELECT
                  BillingCountry,
                  SUM(Total) AS TotalSales
                FROM
                  Invoice
                GROUP BY
                  BillingCountry
                ORDER BY
                  TotalSales DESC;")

    ผลลัพธ์:

       BillingCountry TotalSales
    1             USA     523.06
    2          Canada     303.96
    3          France     195.10
    4          Brazil     190.10
    5         Germany     156.48
    6  United Kingdom     112.86
    7  Czech Republic      90.24
    8        Portugal      77.24
    9           India      75.26
    10          Chile      46.62
    11        Ireland      45.62
    12        Hungary      45.62
    13        Austria      42.62
    14        Finland      41.62
    15    Netherlands      40.62
    16         Norway      39.62
    17         Sweden      38.62
    18          Spain      37.62
    19         Poland      37.62
    20          Italy      37.62
    21        Denmark      37.62
    22        Belgium      37.62
    23      Australia      37.62
    24      Argentina      37.62

    ตัวอย่าง #3 – ดึงชื่อเพลงและชื่ออัลบัม 10 อันดับแรก:

    # Query with dbGetQuery() - example 3
    dbGetQuery(con,
               "SELECT
                  T.Name AS TrackName,
                  A.Title AS AlbumTitle
                FROM
                  Track AS T
                JOIN
                  Album AS A ON T.AlbumID = A.AlbumID
                LIMIT 10;")

    ผลลัพธ์:

                                     TrackName                            AlbumTitle
    1  For Those About To Rock (We Salute You) For Those About To Rock We Salute You
    2                        Balls to the Wall                     Balls to the Wall
    3                          Fast As a Shark                     Restless and Wild
    4                        Restless and Wild                     Restless and Wild
    5                     Princess of the Dawn                     Restless and Wild
    6                    Put The Finger On You For Those About To Rock We Salute You
    7                          Let's Get It Up For Those About To Rock We Salute You
    8                         Inject The Venom For Those About To Rock We Salute You
    9                               Snowballed For Those About To Rock We Salute You
    10                              Evil Walks For Those About To Rock We Salute You

    .

    3️⃣ dbSendQuery()

    dbSendQuery() ทำงานเหมือนกับ dbGetQuery() แต่ต่างกันที่ dbGetQuery() จะยังส่งข้อมูลใด ๆ กลับมาจนกว่าเราจะเรียกดูด้วย dbFetch()

    ยกตัวอย่างเช่น ดูข้อมูลลูกค้า 10 รายชื่อแรกเมื่อเรียงตามนามสกุล:

    # Send query
    res <- dbSendQuery(con,
                       "SELECT
                          CustomerId,
                          LastName,
                          FirstName,
                          Email
                        FROM
                          Customer
                        ORDER BY
                          LastName
                        LIMIT 10;")
    
    # Fetch results
    dbFetch(res)

    ผลลัพธ์:

       CustomerId   LastName FirstName                         Email
    1          12    Almeida   Roberto roberto.almeida@riotur.gov.br
    2          28    Barnett     Julia           jubarnett@gmail.com
    3          39    Bernard   Camille      camille.bernard@yahoo.fr
    4          18     Brooks  Michelle             michelleb@aol.com
    5          29      Brown    Robert              robbrown@shaw.ca
    6          21      Chase     Kathy           kachase@hotmail.com
    7          26 Cunningham   Richard      ricunningham@hotmail.com
    8          41     Dubois      Marc       marc.dubois@hotmail.com
    9          34  Fernandes      João           jfernandes@yahoo.pt
    10         30    Francis    Edward           edfrancis@yachoo.ca

    เมื่อเราเรียกดูข้อมูลทั้งหมดแล้ว เราจะไม่สามารถเรียกดูซ้ำได้:

    # Fetch results
    dbFetch(res)

    ผลลัพธ์:

    > dbFetch(res)
    [1] CustomerId LastName   FirstName  Email     
    <0 rows> (or 0-length row.names)

    ทั้งนี้ เราสามารถกำหนดจำนวนข้อมูลที่จะเรียกดูในแต่ละครั้งได้ เช่น:

    # Send query
    res <- dbSendQuery(con,
                       "SELECT
                          CustomerId,
                          LastName,
                          FirstName,
                          Email
                        FROM
                          Customer
                        ORDER BY
                          LastName
                        LIMIT 10;")
    
    # Fetch five, twice
    dbFetch(res, n = 5)
    dbFetch(res, n = 5)
    dbFetch(res, n = 5)

    ผลลัพธ์:

    > dbFetch(res, n = 5)
      CustomerId LastName FirstName                         Email
    1         12  Almeida   Roberto roberto.almeida@riotur.gov.br
    2         28  Barnett     Julia           jubarnett@gmail.com
    3         39  Bernard   Camille      camille.bernard@yahoo.fr
    4         18   Brooks  Michelle             michelleb@aol.com
    5         29    Brown    Robert              robbrown@shaw.ca
    > dbFetch(res, n = 5)
      CustomerId   LastName FirstName                    Email
    1         21      Chase     Kathy      kachase@hotmail.com
    2         26 Cunningham   Richard ricunningham@hotmail.com
    3         41     Dubois      Marc  marc.dubois@hotmail.com
    4         34  Fernandes      João      jfernandes@yahoo.pt
    5         30    Francis    Edward      edfrancis@yachoo.ca
    > dbFetch(res, n = 5)
    [1] CustomerId LastName   FirstName  Email     
    <0 rows> (or 0-length row.names)

    เราสามารถใช้ dbSendQuery() และ dbFetch() เพื่อดูข้อมูลเป็นชุด ๆ แทนที่จะดูข้อมูลทั้งหมดในครั้งเดียวแบบ dbGetQuery()

    Note: ในกรณีที่เราต้องการลบ query ที่เราส่งไป database ด้วย dbSendQuery() ให้เราใช้ dbClearResult():

    # Clear results
    dbClearResult(res)

    🤚 Step 4. Close the Connection

    สุดท้าย เมื่อเราทำงานกับ database เสร็จแล้ว เราต้องสิ้นสุดการเชื่อมต่อกับ database ด้วย dbDisconnect():

    # Close the connection
    dbDisconnect(con)

    เป็นอันจบการทำงานกับ database ด้วย DBI


    💪 Summary

    ในบทความนี้ เราได้ไปดูวิธีการใช้งาน DBI เพื่อทำงานกับ database กัน:

    เชื่อมต่อ database:

    • dbConnect()

    สำรวจ database:

    • dbListTables()
    • dbGetQuery()

    Query ข้อมูล:

    • dbReadTable()
    • dbGetQuery()
    • dbSendQuery(), dbFetch(), และ dbClearResult()

    ปิดการเชื่อมต่อ:

    • dbDisconnect()

    😺 GitHub

    ดู code และ database ในบทความนี้ได้ที่ GitHub


    📃 References


    ✅ R Book for Psychologists: หนังสือภาษา R สำหรับนักจิตวิทยา

    📕 ขอฝากหนังสือเล่มแรกในชีวิตด้วยนะครับ 😆

    🙋 ใครที่กำลังเรียนจิตวิทยาหรือทำงานสายจิตวิทยา และเบื่อที่ต้องใช้ software ราคาแพงอย่าง SPSS และ Excel เพื่อทำข้อมูล

    💪 ผมขอแนะนำ R Book for Psychologists หนังสือสอนใช้ภาษา R เพื่อการวิเคราะห์ข้อมูลทางจิตวิทยา ที่เขียนมาเพื่อนักจิตวิทยาที่ไม่เคยมีประสบการณ์เขียน code มาก่อน

    ในหนังสือ เราจะปูพื้นฐานภาษา R และพาไปดูวิธีวิเคราะห์สถิติที่ใช้บ่อยกัน เช่น:

    • Correlation
    • t-tests
    • ANOVA
    • Reliability
    • Factor analysis

    🚀 เมื่ออ่านและทำตามตัวอย่างใน R Book for Psychologists ทุกคนจะไม่ต้องพึง SPSS และ Excel ในการทำงานอีกต่อไป และสามารถวิเคราะห์ข้อมูลด้วยตัวเองได้ด้วยความมั่นใจ

    แล้วทุกคนจะแปลกใจว่า ทำไมภาษา R ง่ายขนาดนี้ 🙂‍↕️

    👉 สนใจดูรายละเอียดหนังสือได้ที่ meb:

  • 7 คำสั่ง SQL ที่คนทำงานสาย Data ควรรู้

    7 คำสั่ง SQL ที่คนทำงานสาย Data ควรรู้

    Updated: 13 Sep 2026

    .

    ในยุคที่ข้อมูล (data) เป็นทรัพยากรที่สำคัญทางธุรกิจ SQL เป็นทักษะที่คนทำงานสาย data ควรมีติดตัว

    SQL ย่อมาจาก Structured Query Language และเป็นภาษาสำหรับทำงานกับฐานข้อมูล (database) เช่น:

    • สร้างและจัดการ database
    • เรียกดูข้อมูลจาก database
    • จัดการข้อมูลบน database
    • วิเคราะห์ข้อมูลบน database

    ในบทความนี้ เราจะทำความรู้จักกับ 7 คำสั่ง SQL ที่คนทำงานสาย data ควรรู้กัน:

    1. SELECT
    2. WHERE
    3. ORDER BY
    4. GROUP BY
    5. Aggregate functions
    6. JOIN
    7. LIMIT

    ถ้าพร้อมแล้วไปเริ่มกันเลย


    💽 Database ตัวอย่าง

    สำหรับบทความนี้ เราจะใช้ Chinook database เป็นตัวอย่างกัน:

    Chinook database มีข้อมูลร้านขายมีเดียออนไลน์ ซึ่งแบ่งออกเป็น 11 ชุดข้อมูล (table):

    No.Table NameDescription
    1Albumข้อมูลอัลบัม
    2Artistข้อมูลศิลปิน
    3Customerข้อมูลลูกค้า
    4Employeeข้อมูลพนักงาน
    5Genreข้อมูลแนวเพลง
    6Invoiceข้อมูลใบเสร็จขายของ
    7InvoiceLineข้อมูลรายการซื้อในใบเสร็จ
    8MediaTypeข้อมูลประเภทมีเดีย
    9Playlistข้อมูลเพลย์ลิสต์
    10PlaylistTrackข้อมูลสำหรับจับคู่เพลย์ลิสต์กับเพลง
    11Trackข้อมูลเพลง

    เราไปดูวิธีใช้ 7 คำสั่ง SQL กับ Chinook database กัน


    1️⃣ คำสั่ง #1: SELECT

    .

    👉 วิธีใช้งาน

    ใช้เลือกข้อมูลจาก database

    SELECT columns
    FROM table
    • columns ใช้กำหนด column ที่ต้องการ (ระบุได้มากกว่า 1 โดยใช้ , คั่น)
    • table ใช้กำหนด table ที่ต้องการ

    .

    💿 ตัวอย่าง

    เลือกชื่อเพลง (Name) และรหัสอัลบัม (AlbumID) จาก Track:

    SELECT Name, AlbumId
    FROM Track;

    ผลลัพธ์:

    .

    💡 เทคนิคการใช้งานเพิ่มเติม

    ข้อ 1. *:

    ใช้ * เพื่อเลือกทุก column เช่น:

    SELECT *
    FROM Tracks;

    จะแสดงข้อมูลจากทุก column ใน Track

    ข้อ 2. AS:

    ใช้ AS เพื่อเปลี่ยนชื่อ column เช่น:

    SELECT
    Name AS Song,
    AlbumId AS Album
    FROM Track;

    ผลลัพธ์:

    สังเกตว่า เราได้ข้อมูลเหมือนเดิม แต่ชื่อ column เปลี่ยนไป


    2️⃣ คำสั่ง #2: WHERE

    .

    👉 วิธีใช้งาน

    ใช้กรองข้อมูล

    WHERE conditions
    • conditions ใช้กำหนดเงื่อนไขการกรอง

    .

    💿 ตัวอย่าง

    หาเพลงที่มีราคา (UnitPrice) สูงกว่า $0.99:

    SELECT Name, UnitPrice
    FROM Track
    WHERE UnitPrice > 0.99;

    ผลลัพธ์:

    .

    💡 เทคนิคการใช้งานเพิ่มเติม

    ข้อ 1. Operator:

    เราสามารถใช้ operator เหล่านี้คู่กับ WHERE เพื่อกำหนดเงื่อนไขได้:

    OperatorMeaningExample
    =เท่ากับUnitPrice = 0.99
    <> หรือ !=ไม่เท่ากับUnitPrice <> 0.99
    >มากกว่าUnitPrice > 0.99
    <น้อยกว่าUnitPrice < 0.99
    >=มากกว่า/เท่ากับUnitPrice >= 0.99
    <=น้อยกว่า/เท่ากับUnitPrice <= 0.99
    BETWEENกรองข้อมูลตามช่วงUnitPrice BETWEEN 0.99 and 1.99
    INกรองข้อมูลตามเซตUnitPrice IN (0.99, 1.99, 2.99)

    ข้อ 2. LIKE:

    ใช้ LIKE เพื่อกรองข้อมูลที่เป็น text โดยใช้คู่กับ 2 อย่างนี้:

    OperatorMeaning
    _แทนอักขระ 1 ตัว
    %แทนอักขระกี่ตัวก็ได้

    ตัวอย่างการใช้ _:

    SELECT FirstName, LastName
    FROM Customer
    WHERE FirstName LIKE '_ohn';

    เราจะได้ข้อมูลที่ FirstName ขึ้นต้นด้วยตัวอักษรใด ๆ 1 ตัว และตาม “ohn”

    เช่น:

    • John
    • Gohn
    • Wohn

    ตัวอย่างการใช้ %:

    SELECT FirstName, LastName
    FROM Customer
    WHERE FirstName LIKE 'J%';

    เราจะได้ข้อมูลที่ FirstName ขึ้นต้นด้วย “J” และตามด้วยตัวอักษรใด ๆ กี่ตัวก็ได้

    เช่น:

    • John
    • Jo
    • Jane
    • James

    3️⃣ คำสั่ง #3: ORDER BY

    .

    👉 วิธีใช้งาน

    จัดลำดับข้อมูล

    ORDER BY columns
    • columns ใช้กำหนด column ที่ใช้จัดลำดับข้อมูล (ใส่ได้มากกว่า 1)

    .

    💿 ตัวอย่าง

    ดึงรายชื่อลูกค้า ให้แสดงตามชื่อจริง (FirstName):

    SELECT FirstName, LastName
    FROM Customer
    ORDER BY FirstName;

    ผลลัพธ์:

    .

    💡 เทคนิคการใช้งานเพิ่มเติม

    ข้อ 1. DESC:

    ORDER BY จะเรียงแบบ ascending (A–Z) โดยอัตโนมัติ

    ถ้าต้องการเรียงแบบ descending (Z–A) ให้ใช้ DESC เช่น:

    SELECT FirstName, LastName
    FROM Customer
    ORDER BY FirstName DESC;

    ผลลัพธ์:


    4️⃣ คำสั่ง #4: GROUP BY

    .

    👉 วิธีใช้งาน

    จับกลุ่มข้อมูล

    GROUP BY columns
    • columns ใช้กำหนด column ที่ใช้จับกลุ่มข้อมูล (ใส่ได้มากกว่า 1)

    .

    💿 ตัวอย่าง

    นับจำนวนลูกค้าในแต่ละประเทศ:

    SELECT
    Country,
    COUNT(*) AS CountryCount
    FROM Customer
    GROUP BY Country;

    ผลลัพธ์:


    5️⃣ คำสั่ง #5: Aggregate Functions

    .

    👉 วิธีใช้งาน

    สรุปข้อมูล (aggregate)

    agg(column)
    • agg ใช้กำหนด aggregate function ที่จะใช้งาน
    • column ใช้กำหนด column ที่เป็น input ให้กับ aggregate function

    ใน SQL เรามี 5 functions ที่ใช้บ่อย ได้แก่:

    No.AggregateDescription
    1COUNT()นับจำนวนข้อมูล
    2SUM()หาผลรวม (sum)
    3AVG()หาค่าเฉลี่ย (mean)
    4MIN()หาค่าต่ำสุด (min)
    5MAX()หาค่าสูงสุด (max)

    .

    💿 ตัวอย่าง

    เราต้องการรู้ข้อมูลการใช้จ่ายของลูกค้าแต่ละคน:

    • จำนวนครั้งในการซื้อ (count)
    • เงินที่เคยใช้จ่ายทั้งหมด (sum)
    • ค่าใช้จ่ายโดยเฉลี่ย (mean)
    SELECT
    CustomerId,
    COUNT(*),
    SUM(Total) AS TotalSpent,
    AVG(Total) AS AverageSpent
    FROM Invoice
    GROUP BY CustomerId;

    ผลลัพธ์:


    6️⃣ คำสั่ง #6: JOIN

    .

    👉 วิธีใช้งาน

    ใช้เชื่อม table

    SELECT columns
    FROM table1
    JOIN table2
    ON table1.key1 on table2.key2
    • table1, table2 คือ tables ที่จะเชื่อมกัน
    • key1, key2 คือ columns ที่เป็นจุดเชื่อมของ 2 tables (สิ่งที่เรียกว่า primary key, foreign key)

    .

    💿 ตัวอย่าง

    เชื่อม Track เข้ากับ Album เพื่อดูว่า แต่ละเพลงมาจากอัลบัลไหน:

    SELECT
    Track.Name AS TrackName,
    Album.Title AS AlbumName
    FROM Track
    JOIN Album
    ON Track.AlbumId = Album.AlbumId;

    ผลลัพธ์:


    7️⃣ คำสั่ง #7: LIMIT

    .

    👉 วิธีใช้งาน

    จำกัดข้อมูลที่นำมาแสดงผล

    LIMIT x
    • x คือ จำนวนข้อมูลที่ต้องการ

    .

    💿 ตัวอย่าง

    แสดงข้อมูลลูกค้า 10 คนแรก:

    SELECT FirstName, LastName
    FROM Customer
    LIMIT 10;

    ผลลัพธ์:


    💪 ใช้คำสั่ง SQL ร่วมกัน

    เราสามารถใช้คำสั่ง SQL ทั้งหมดร่วมกัน เพื่อตอบโจทย์ data ที่ซับซ้อนได้

    ตัวอย่าง:

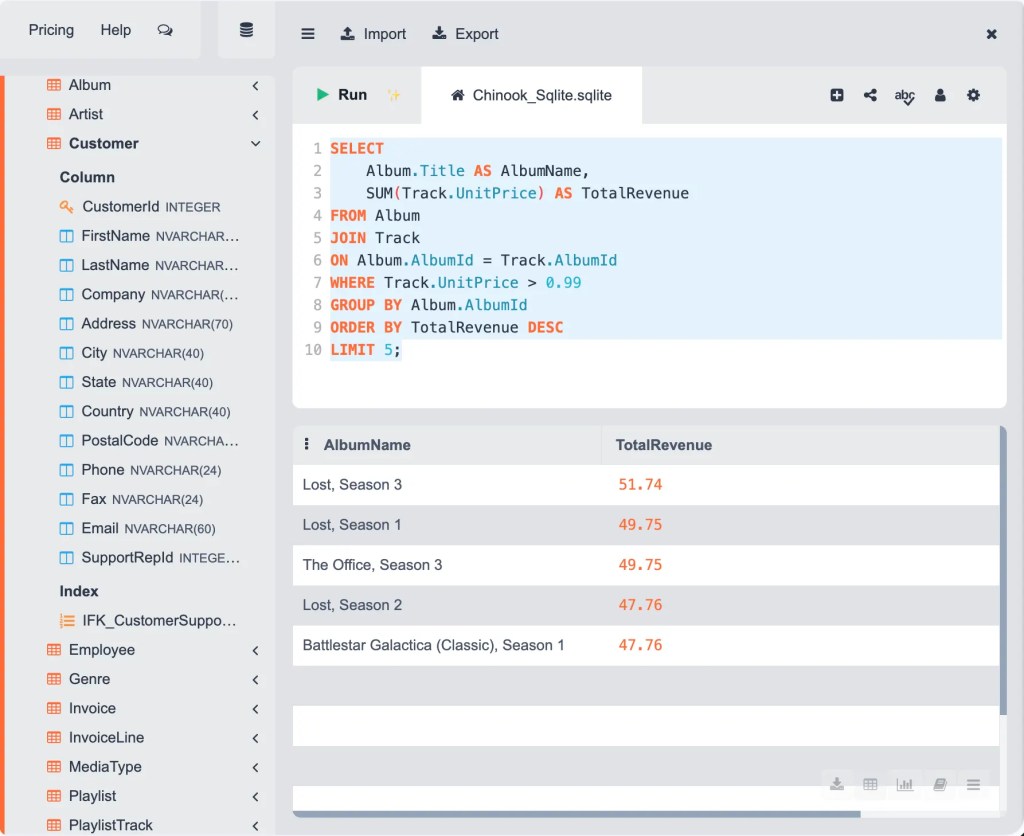
    หา 5 อัลบัมที่ขายดีที่สุด ซึ่งมีเพลงราคาตั้งแต่ $0.99 ขึ้นไป:

    SELECT
    Album.Title AS AlbumName,
    SUM(Track.UnitPrice) AS TotalRevenue
    FROM Album
    JOIN Track
    ON Album.AlbumId = Track.AlbumId
    WHERE Track.UnitPrice > 0.99
    GROUP BY Album.AlbumId
    ORDER BY TotalRevenue DESC
    LIMIT 5;
    • ใช้ SELECT เพื่อเลือกอัลบัมและหาผลรวมยอดขาย (SUM)
    • เชื่อม tables (JOIN) เพื่อดึงข้อมูลราคาเพลง จาก Track
    • กรองเฉพาะเพลงที่มีราคาตั้งแต่ $0.99 (WHERE)
    • จับกลุ่มข้อมูล (GROUP BY) เพื่อหาผลรวมของแต่ละอัลบัม
    • จัดเรียงข้อมูล (ORDER BY) ตามผลรวมยอดขาย โดยเรียงจากมากไปน้อย (DESC)
    • เลือกแสดงข้อมูล 5 อันดับแรก (LIMIT)

    ผลลัพธ์:


    🍩 โบนัส: การเขียน SQL ที่ดี

    การเขียน SQL ที่ดี มี 3 ข้อ:

    ข้อ 1. ใช้ UPPERCASE สำหรับคำสั่ง เช่น:

    • ✅ Do: SELECT, WHERE, GROUP BY
    • ❌ Don’t: select, where, group by

    ข้อ 2. ใช้ snake_case สำหรับชื่อ table และ column เช่น:

    • user_id
    • order_date
    • duration_ms

    ข้อ 3. เคาะย่อหน้า (indentation) และแบ่งบรรทัด เพื่อให้อ่านง่าย เช่น:

    -- ✅ เขียนแบบนี้:
    SELECT
    FirstName,
    LastName
    FROM Customer
    ORDER BY LastName;
    -- ❌ แทนแบบนี้:
    SELECT FirstName, LastName
    FROM Customer
    ORDER BY LastName;

    Note: ดูไกด์ไลน์เพิ่มเติมในการเขียน SQL ที่ดี ได้ที่ SQL Style Guide


    ⏭️ หลังจบบทความนี้

    .

    😺 ดูตัวอย่าง Code และ Database

    ดู database และตัวอย่าง SQL ทั้งหมดในบทความ ได้ที่ GitHub

    .

    🔨 เครื่องมือใช้งาน SQL

    สำหรับใครที่อยากฝึก SQL สามารถใช้ SQL ฟรีได้บน sqliteonline.com

    .

    📖 คู่มือการใช้ SQL

    สำหรับใครที่อยากศึกษาคำสั่ง SQL นอกเหนือจากนี้ สามารถอ่านเพิ่มได้ที่ SQL Tutorial จาก W3Schools

    • ฟรี
    • เข้าใจง่าย

    📃 อ้างอิง